wc -l의 숫자는 CSV 행 수가 아니었다
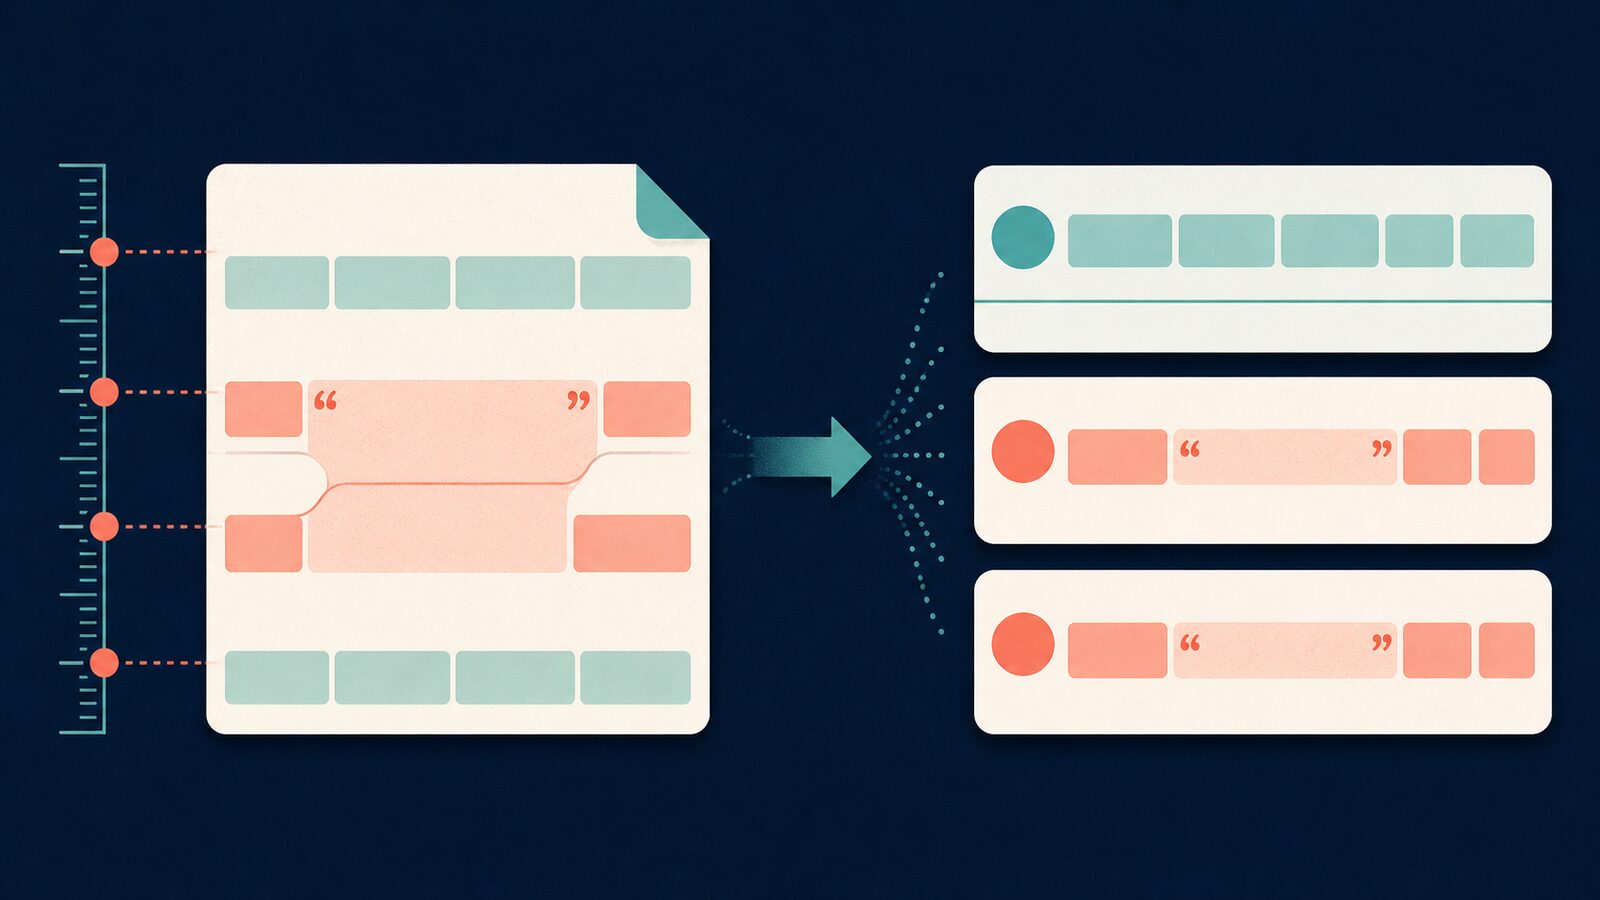
병합 전 CSV는 2,416이었다.
병합 후 데이터는 2,362였다.
54개가 사라진 것처럼 보였다.
숫자가 너무 깔끔해서 의심하기 어려웠다.
2,416은 wc -l이 셌고, 2,362는 CSV를 읽는 코드가 셌다.
두 명령은 같은 파일을 봤다.
그러나 같은 것을 세지 않았다.
wc는 거짓말하지 않았다
현재 macOS의 wc(1) 설명은 line을 newline 문자로 끝나는 문자열로 정의한다.
마지막 newline 뒤의 문자는 line count에 포함하지 않는다는 주의도 붙어 있다.
그러니 다음 명령이 세는 것은 파일 안의 newline으로 구분된 물리 줄이다.
wc -l export.csv
명령 이름에도 CSV는 없다.
quote도 모른다.
header도 모른다.
delimiter도 모른다.
그런데 우리는 출력된 숫자에 “CSV 행 수”라는 이름을 붙였다.
도구가 틀린 답을 낸 게 아니다.
내가 다른 질문의 답을 가져왔다.
CSV 레코드는 물리 한 줄보다 길 수 있다
RFC 4180은 CSV의 널리 쓰이는 형식을 문서화한 Informational RFC다.
그 문서의 escaped field 문법은 CR과 LF를 필드 안에 둘 수 있게 한다.
줄바꿈이 든 필드는 double quote로 감싼다.
예를 들어 메모 하나가 두 줄일 수 있다.
id,note
1,"alpha
beta"
2,gamma
눈으로 보면 네 줄이다.
CSV parser가 읽는 record는 세 개다.
header 하나와 data record 두 개다.
alpha와 beta 사이의 줄바꿈은 record 경계가 아니다.
첫 번째 data record 안의 문자다.
작은 fixture가 질문을 분리했다
먼저 줄바꿈 필드가 없는 fixture를 만들었다.
id,note
1,alpha
2,beta
두 reader의 결과가 모두 3이었다.
wc -l:       3
csv.reader:  3
이 fixture만 보고 wc -l을 CSV row counter로 승인하면 안 된다.
reader 둘이 우연히 같은 숫자를 낼 수밖에 없는 입력이기 때문이다.
그래서 한 필드에 CRLF 하나를 넣었다.
id,note
1,"alpha
beta"
2,gamma
이번에는 결과가 갈렸다.
wc -l:       4
csv.reader:  3
CSV record 수는 그대로다.
물리 newline 수만 하나 늘었다.
확인에 쓴 parser 명령은 단순했다.
python3 -c 'import csv, sys; print(sum(1 for _ in csv.reader(sys.stdin)))' < fixture.csv
이 숫자에는 header가 포함된다.
data record만 필요하다면 header 존재 여부를 먼저 정하고 그 계약에 맞춰 세어야 한다.
무조건 1을 빼는 것도 또 다른 proxy다.
54개가 사라진 이야기는 왜 그럴듯했나
2,416과 2,362의 차이는 정확히 54다.
병합 작업 직후 이런 숫자를 보면 원인을 병합에서 찾게 된다.
deduplication이 너무 공격적이었나.
join key가 틀렸나.
빈 값이 제거됐나.
하지만 그 추론은 두 숫자의 단위가 같을 때만 시작할 수 있다.
한쪽은 물리 줄 수였다.
다른 쪽은 실제 CSV row 수였다.
차이는 유실량이 아니었다.
여러 줄 field가 만든 측정 단위의 차이였다.
정교한 merge 분석을 시작하기 전에 숫자의 reader부터 확인했어야 했다.
count에는 owner가 있다
CSV row 수를 알고 싶다면 CSV 문법을 읽는 도구가 세어야 한다.
애플리케이션이 특정 importer로 파일을 소비한다면 가장 좋은 reader는 그 importer다.
같은 delimiter, quote, escape, encoding, header 규칙을 적용하기 때문이다.
일반 CSV parser는 빠른 독립 대조군으로 쓸 수 있다.
하지만 production importer와 dialect가 다르면 두 parser의 차이 자체가 다음 조사 대상이다.
핵심은 더 복잡한 명령을 고르는 일이 아니다.
질문의 문법을 아는 reader를 고르는 일이다.
숫자를 믿기 전에 단위를 출력한다
앞으로 CSV 검증에서는 count 옆에 의미를 붙인다.
physical_newline_count: 2416
parsed_record_count:     2362
header_included:         true
parser:                  application importer
이 네 줄이면 54를 “사라진 row”라고 부르는 실수를 막을 수 있다.
두 count가 다르다는 사실은 실패가 아니다.
무엇을 세었는지 숨긴 채 숫자만 비교하는 것이 실패다.
실전 규칙
wc -l은 newline으로 구분된 물리 줄을 센다.
CSV의 quoted field에는 줄바꿈이 들어갈 수 있다.
그러므로 physical line count와 parsed record count는 다를 수 있다.
row count는 실제 consumer와 같은 CSV 문법을 쓰는 reader로 구한다.
fixture에는 반드시 여러 줄 field를 넣어 reader 차이가 드러나는지 확인한다.
header 포함 여부와 parser 이름을 count 옆에 기록한다.
마지막으로
wc -l은 빠르다.
그래서 더 위험할 때가 있다.
숫자가 즉시 나오면 우리는 그 숫자에 필요한 이름을 붙인다.
하지만 명령은 이름까지 책임지지 않는다.
newline 수를 row 수라고 부르는 순간, 멀쩡한 데이터 54개가 사라진다.
파일 안에서가 아니라 우리의 설명 안에서.
다음 글도 받아보세요.
글을 끝까지 읽으셨다면, 다음 글은 받은편지함이나 RSS 리더에서 만나보세요.